sist2 简单易用的全文检索
我的工作要写、参考海量文档,但多台终端获取的海量文件很难整理,全文搜索要建立不小的索引。最近发现 sist2(Simple incremental search tool) 这个简洁的全文搜索项目,帮我实现跨平台访问、搜索并获取文件。
需要参考的材料,按照定稿程度大致分成两类。正儿八经的网摘、报告、期刊论文都算是完全定稿,我用 Zotero 管了起来。但我还有海量的岗位“前任”留下的文档,以及海量的自己写过的文档,Office 文档、PDF、压缩包……加起来超过 40G,它们称不上“佳作”,但也不是“屎山”,多多少少还是有利用价值的,最大的问题在于我懒得去整理它们
在海量文档里找素材,属实是大海捞针。公司信息化水平有限,所以信息检索这块,主要靠个人能力。我平时把这些文件都归档存储在 NAS 上,笔记本电脑只放正在跟进的项目。所以,信息检索分成两部分,笔记本电脑上就用 FileLocator 和 Everything,而在 NAS 上,我一直在找一款能够安装在服务器上、读取现有文件目录、通过 Web 端搜索、支持全文索引和实时搜索的应用。
在对比了 Mayan EDMS, Paperless-ngx, DocFetcher Server, Recoll, mybase 等等多个方案后,我最终找到了 sist2,经过几天使用,发现它在基本功能实现、易用性、使用模式、成本、性能等方面,都满足了我的需求。
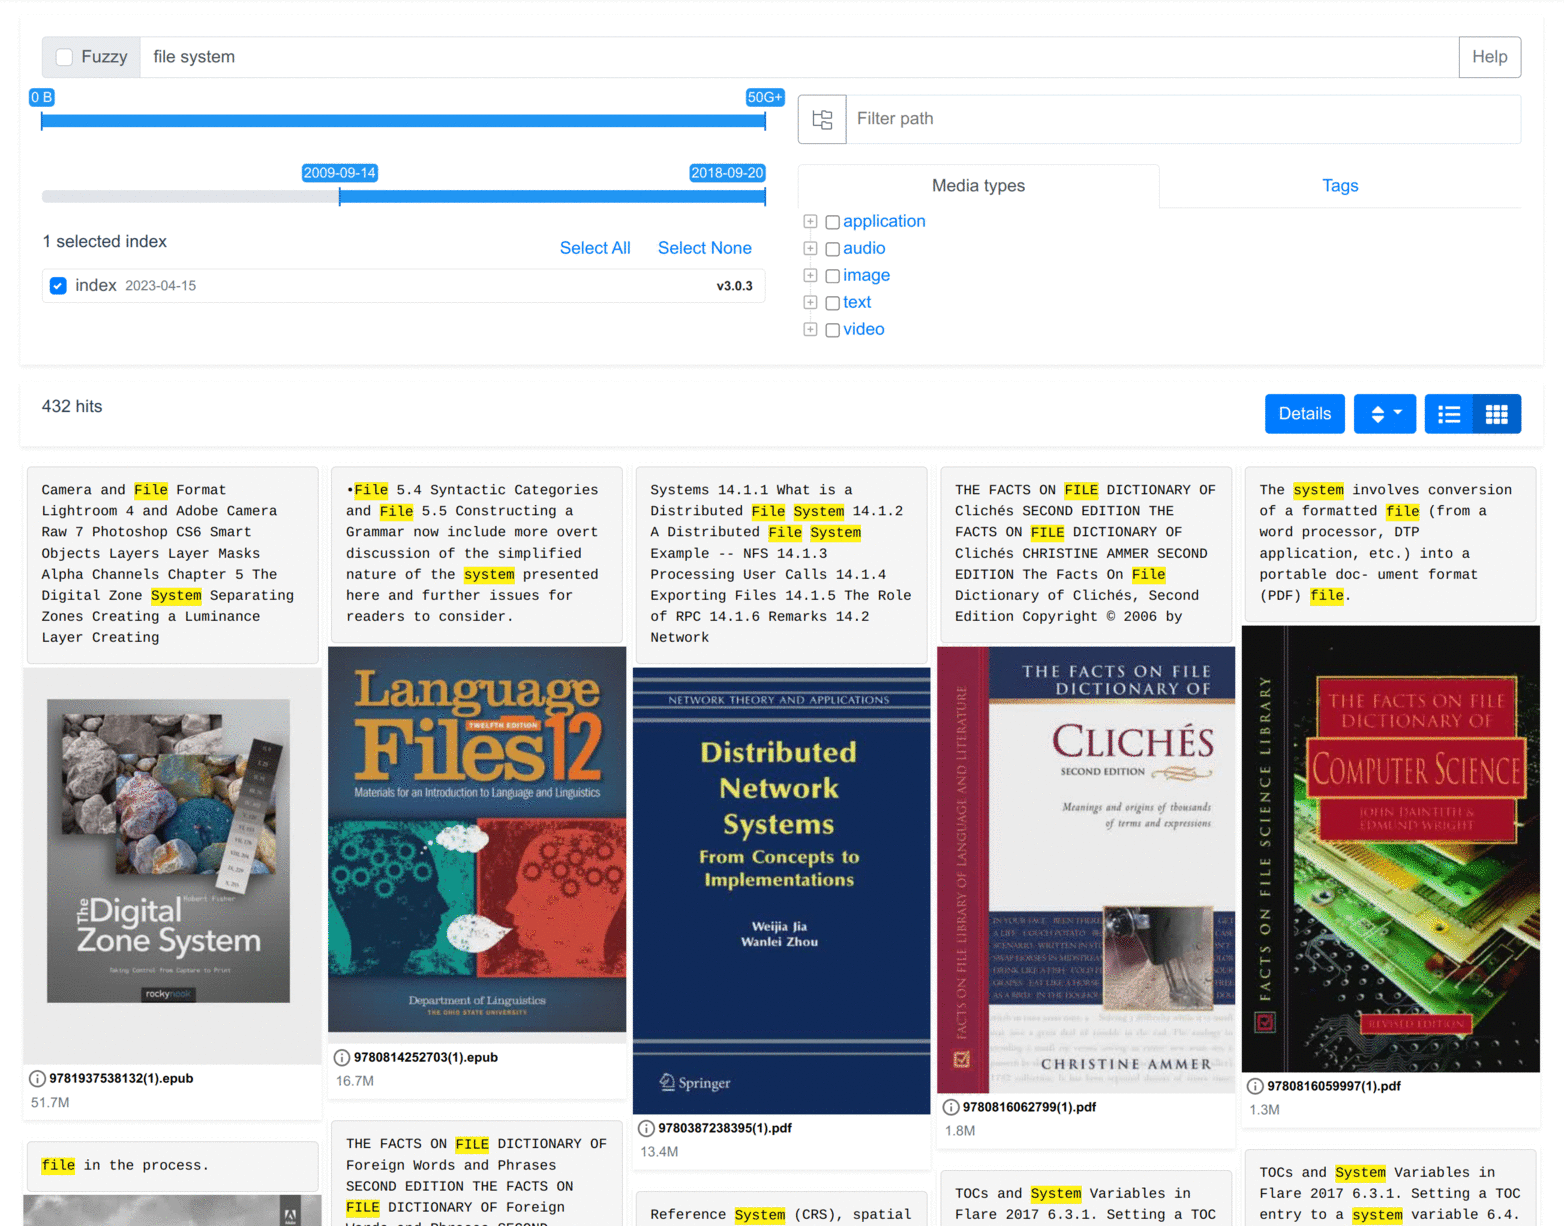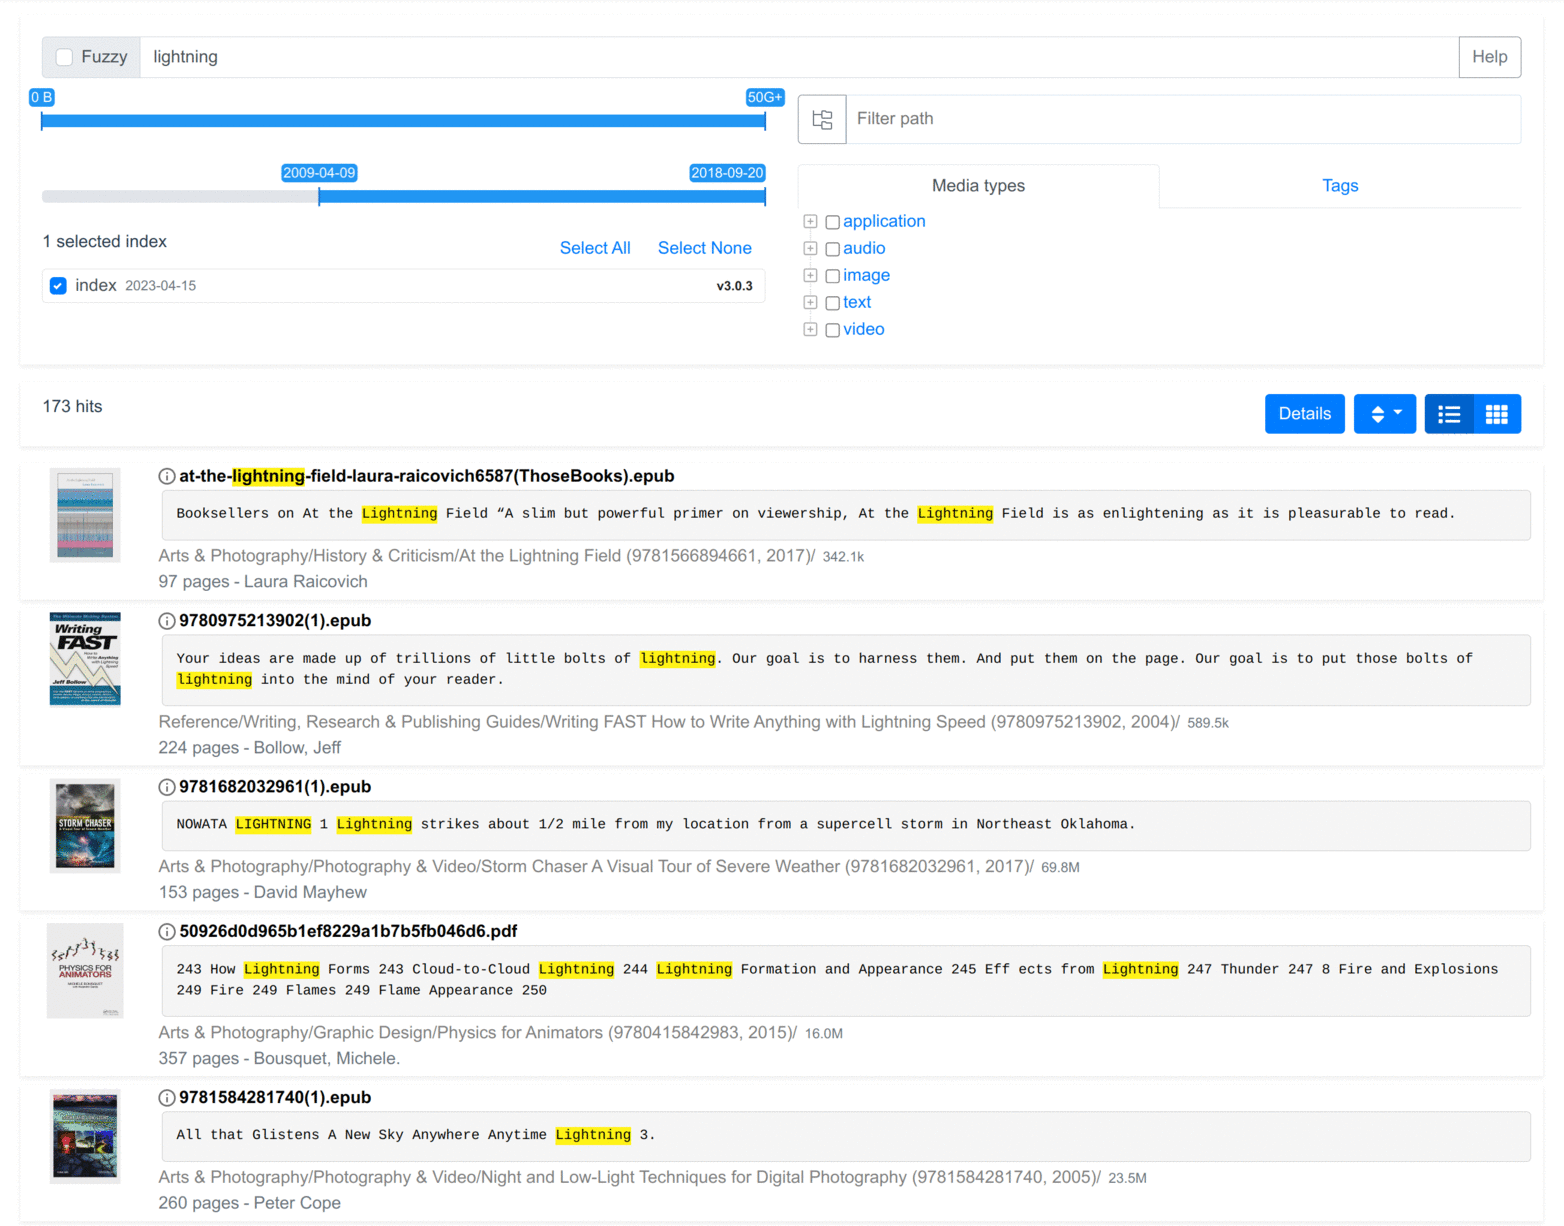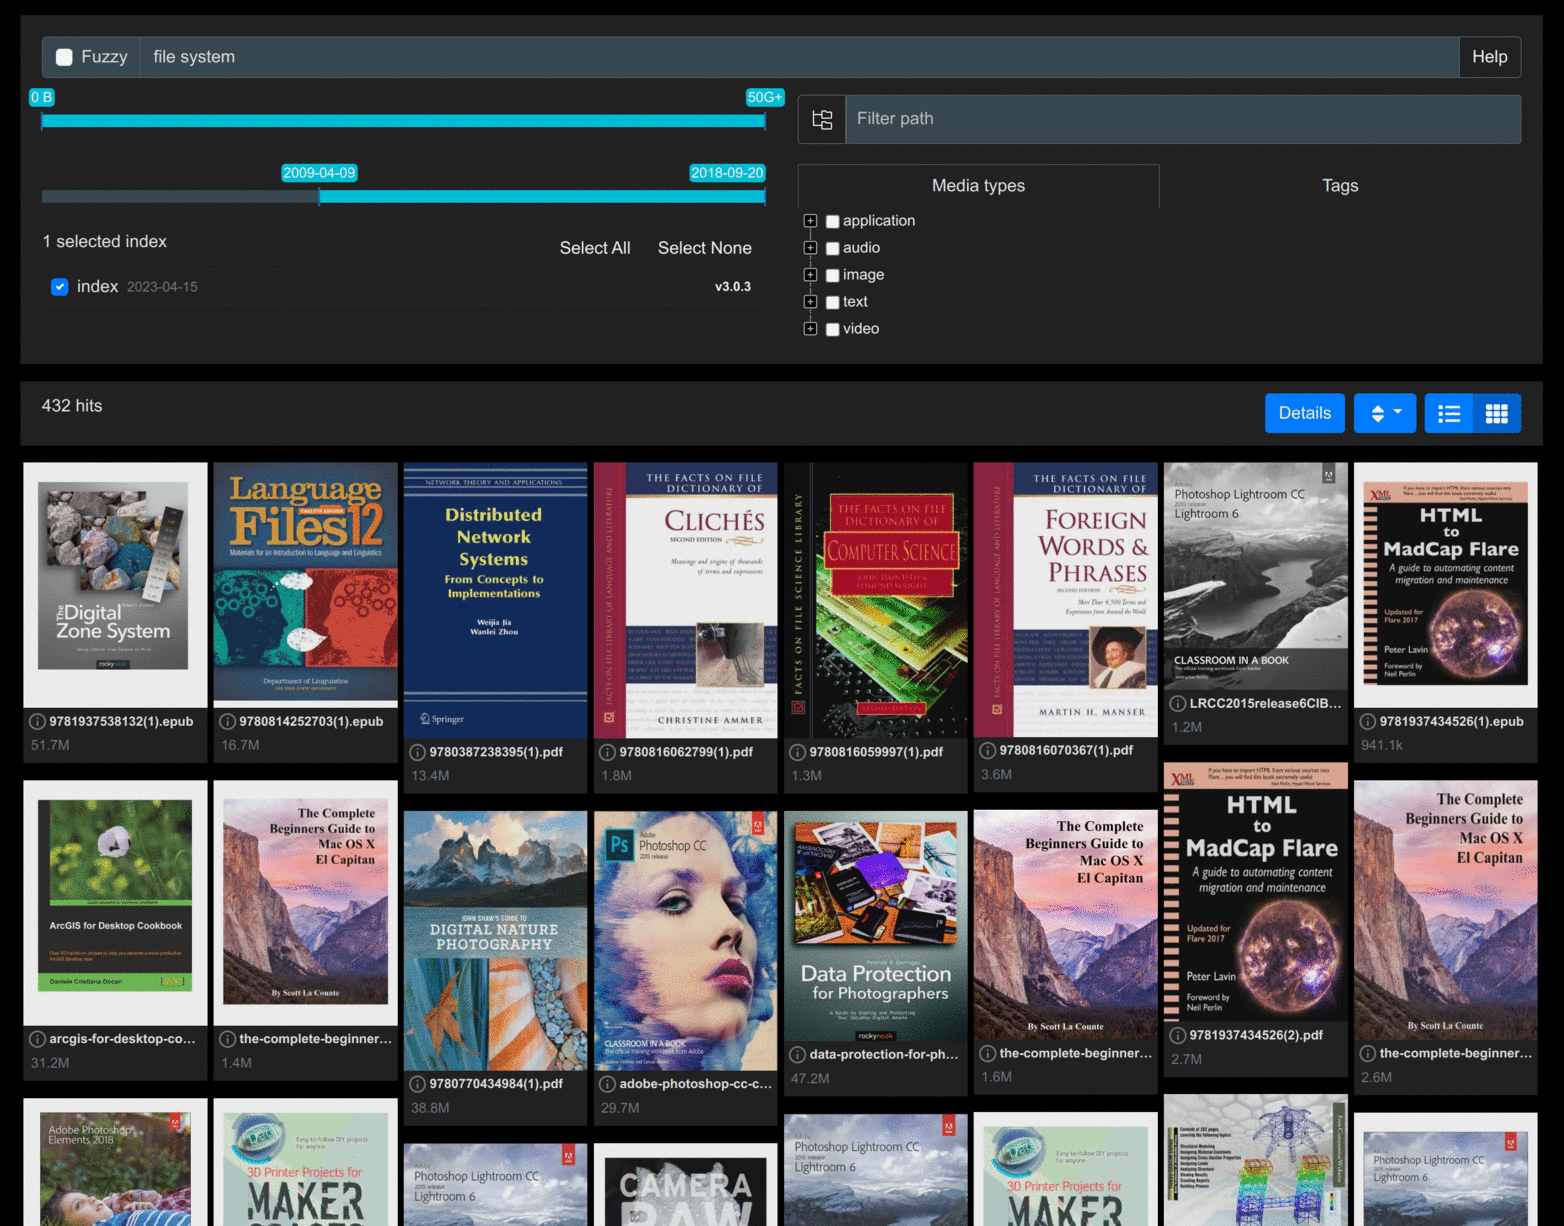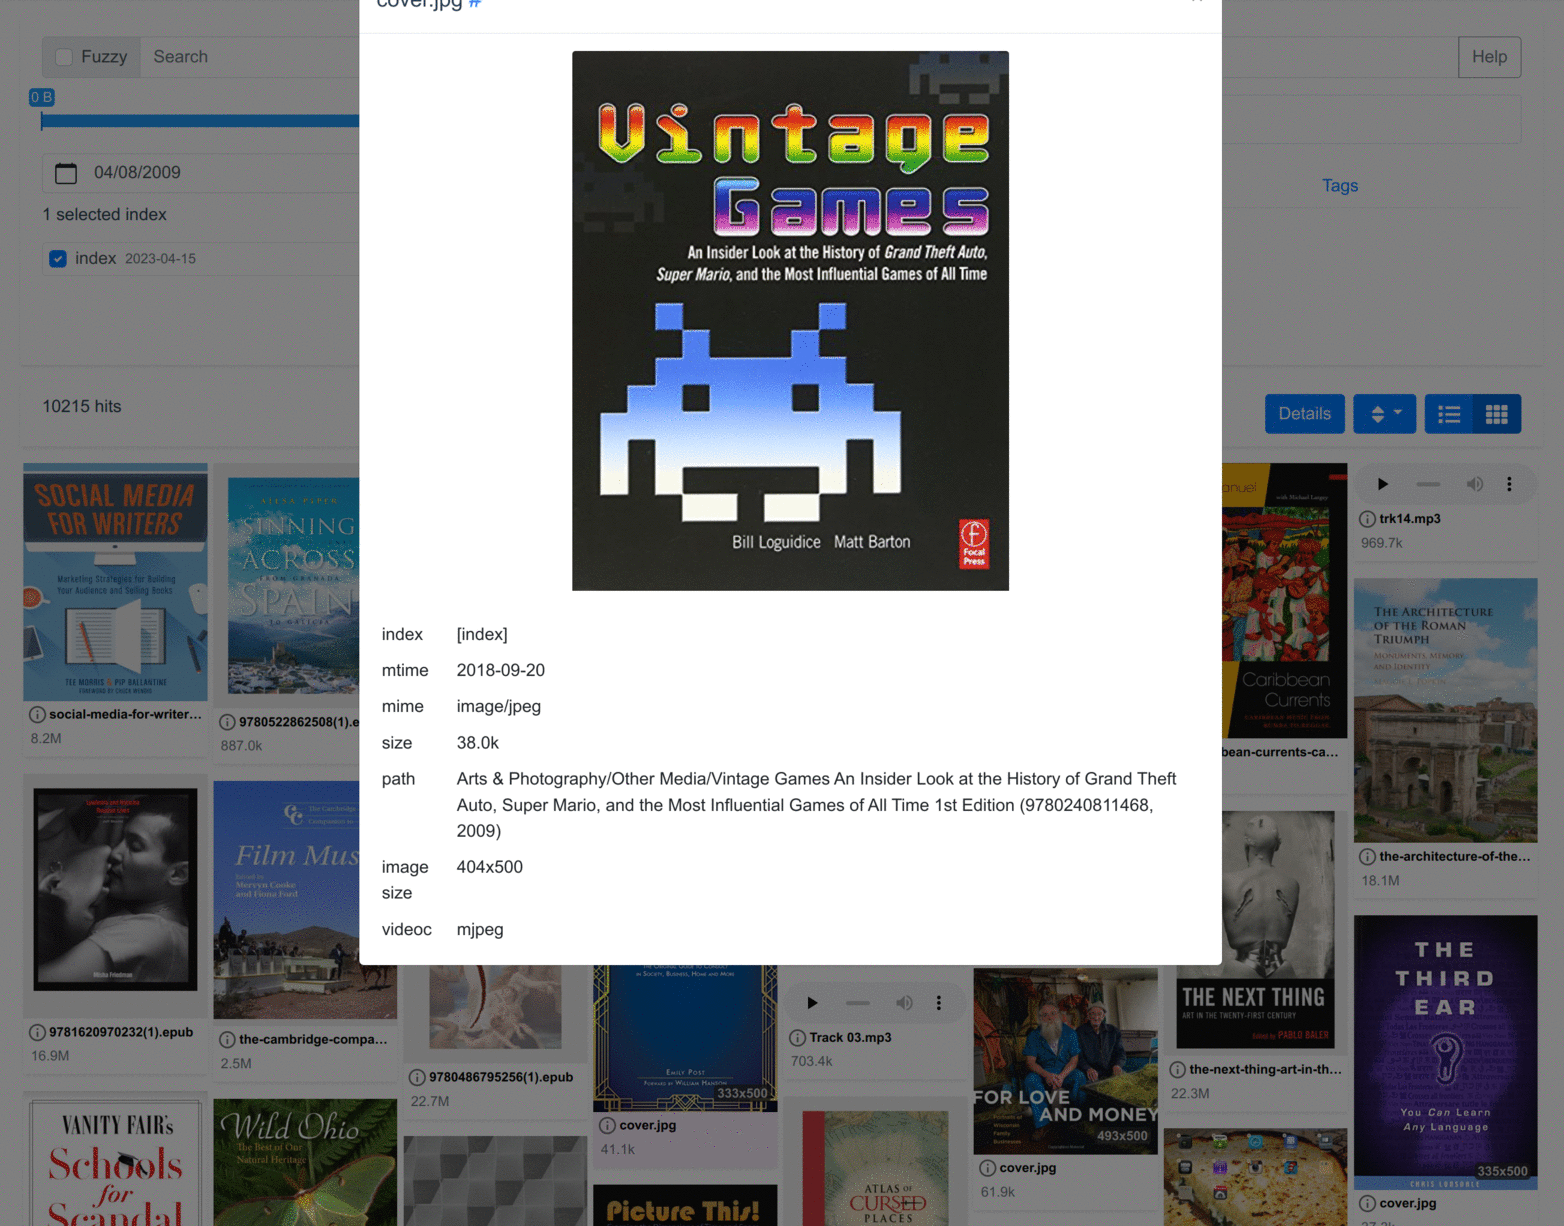
特性
作者对 sist2 特性的介绍我不再赘述,它最吸引我、让我选择它的特性主要是这些:
- 效率高。ElasticSearch 效率很高,资源占用合理。虽然会产生并存储索引,但我有 NAS 无所谓。
- 松耦合。支持基于现有目录,好处是你不需要调整自己的文档备份和存储方式,对我已有的工作流入侵小。不像 nextcloud, Paperless-ngx 等工具那样需要将文档「导入」其文件系统,或是「喂给」其进行处理,使得你必须将这些工具嵌入你的存储工作流。
- 中文可用。对中文关键词的支持还不错,可以通过英文单引号实现中文分词。对比之下,我邮件咨询了 DocFetcher Server,说是完全不支持中文分词,关键词字与字之间是 「或」的关系。
- 方便。支持 Web 端使用,随时随地可查的同时,也使得大量的历史文档不需要保存在笔记本电脑里,减轻了心理负担。
安装
通过 docker 安装和运行 sist2 是最简便的,也最适合 NAS。
version: "3"
services:
    elasticsearch:
        image: elasticsearch:7.17.9
        restart: unless-stopped
        environment:
            - "discovery.type=single-node"
            - "ES_JAVA_OPTS=-Xms2g -Xmx2g"
            - TZ=Asia/Shanghai
        volumes:
            - esdata:/usr/share/elasticsearch/data
        networks:
            network1:
                ipv4_address: 10.0.6.2
    sist2-admin:
        image: simon987/sist2:3.4.0-x64-linux
        restart: unless-stopped
        volumes:
            - /path/to/sist2-admin-data/:/sist2-admin/
            - /path/to/your/docs:/host
        environment:
            - TZ=Asia/Shanghai
        ports:
            - 4090:4090 # sist2
            - 8080:8080 # sist2-admin
        working_dir: /root/sist2-admin/
        entrypoint: python3 /root/sist2-admin/sist2_admin/app.py
        networks:
            network1:
                ipv4_address: 10.0.6.1
    networks:
        network1:
            name: bridge1
            external: true
    volumes: esdata:
- 建议设置时区,任务日志中的执行时间看起来更直观。
- 建议为 es 服务设置卷。项目仓库文档中 elasticsearch 服务没有设置存储,假如你删除了容器、重新部署,前端页面可能会提示
sist2-web 在连接 elasticsearch 的时候出现错误(3.1.4 版本)。虽然重新运行一遍扫描可以解决这个问题,但太耗费时间。本文的 compose 文件中为 es 设置了 volume 而非 bind mount,是因为后者经常因权限问题导致 es 服务反复重启、影响使用。
配置
sist2-admin
通过 IP:8080 访问 sist2-admin,这是管理员控制面板,主要分为 Backends「后端」、User Scripts「用户脚本」和 Frontends「前端」三个版块,右上角可以切换至 Tasks「任务」版块,可以查看所有正在或已经完成的任务。

配置「后端」
「后端」主要管理 Search backends「搜索后端」和 Jobs「负载」。
「搜索后端」用于创建、定义一系列搜索引擎。创建主要指设置搜索引擎的名称,定义主要指设置搜索引擎的类型如 sqlite 或 es,其中 es 类型在定义时选择 es 实例(即创建的容器)。理论上你可以在不同的服务器上运行多个 es 实例,通过定义搜索引擎将它们引入 sist2,例如称作 es1, es2, 等等。

「负载」用于创建和定义一系列负载任务,负载可以看作是一组文档资源、索引参数和索引结果的组合。例如 job1 用于搜索下载的期刊论文, job2 用于搜索微信接收文件夹。以后你可以根据使用目的、用户、权限的差异,将它们自由组合,通过不同的「前端」来访问。「负载」的定义内容主要包括文件路径、扫描计划、搜索引擎、文件类型筛选、OCR 选项、压缩包扫描选项、缩略图选项、用户脚本选项。首次扫描、计划扫描的执行情况都可以在「任务」里查看。

配置「前端」
「前端」用于创建和定义一系列可访问的搜索入口页面。它主要包括监听端口、可用负载、身份认证选项、Web 参数等。
由于出现过一些小问题,Web options 之类的应该需要在 offline 状态下修改。
如果想要通过互联网远程使用,且你的资源不想公开,至少要基础的用户名密码认证,但建议配置更安全的 Auth0,如果国内有类似服务并且调用模式类似的,欢迎推荐给我。

使用
访问
内外网访问均支持,其中外网访问可以采用 frp 和反向代理等。

更新数据
sist2 通过定义「负载」,使得在搜索时可以方便地筛选不同类别的文档资源。
基于这个理念,为了更好地更新这些文档资源,能源源不断地搜索新的文档,我建议你对文档资源的存储方式做适当整理。例如考虑到文档形成方式(接收?创作?)、更新方式(同步盘?FTP?)、整理程度(人工整理?无脑汇总?)、参考价值(垃圾文档多?优质文档多?)。
举个例子,考虑上述因素,我把存量文档分成了 IM 接收文档、自己整理的资料库、归档项目、跟进中项目等多个目录。定期通过 FreeFileSync 将笔记本电脑中对应目录中的新增文件,更新至 NAS。另一种方式是通过坚果云同步盘,每天定时将跟进中的项目文件,从云端更新至 NAS。
更新索引
sist2 中的「负载」支持定时扫描、更新索引,因此你在搜索新文档时速度更快。这里的扫描参数有很多,可以研究相关文档。
